 好客资讯
企业级AI从试点走向规模化 数据底座成新焦点
过去一年,企业级人工智能的应用重心正在位移。从公开信息和主要服务商的产品迭代节奏看,客户的关注点已经从“能不能用”转向“能否稳定地跑在核心业务流程上”。这一转变,把原本处于后排的数据治理、系统集成与组织配套,重新推到了决策桌的中央。
一、评估标准从“演示效果”转向“稳定产出”
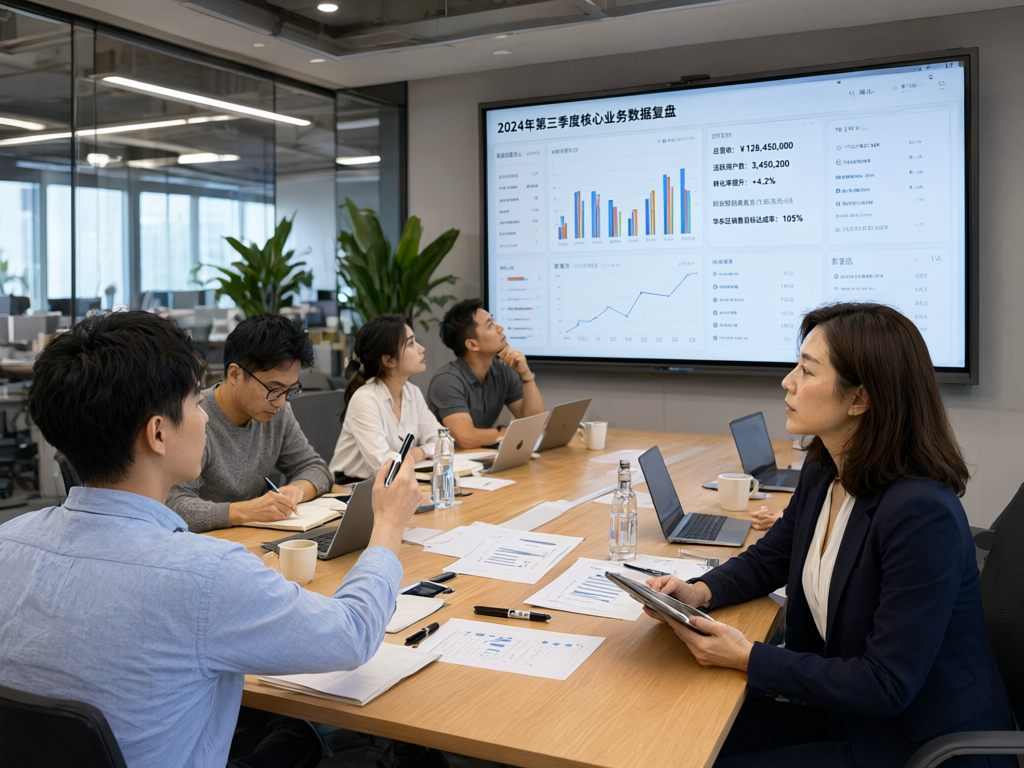
在早期采购中,模型能力与演示效果往往是加分项。如今,越来越多的企业在招标文件里写明任务完成率、结果可回溯性、异常情况下的人工接管路径。智能体进入报销、客服、合同初审等环节后,权限边界、审批节点与操作日志成为必须回答的问题。据公开信息,部分服务商已把计费方式从按席位收费转向按任务量或按效果结算,这从侧面说明,买方对价值的衡量正在变得具体而可量化。
二、数据底座被重新写进前置清单
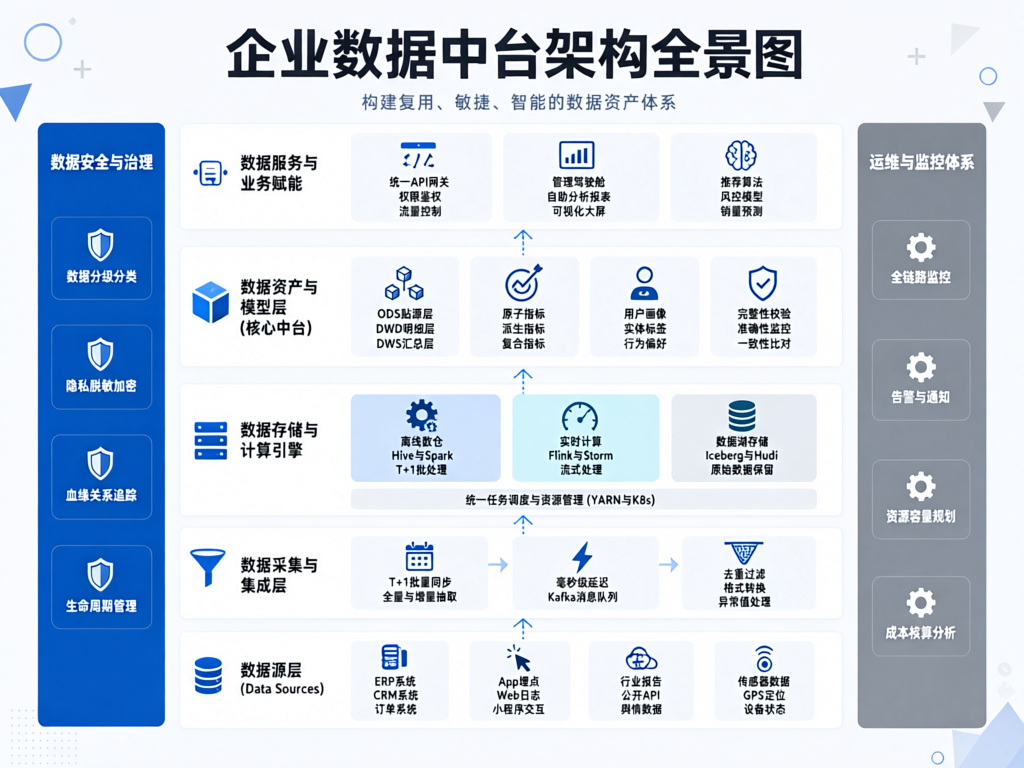
当模型之间的能力差距收窄,竞争便回到数据本身。此前一度被讨论“是否过时”的中台概念,正以数据底座、企业知识库、统一接口层的形式回归。项目立项之前,结构化数据的完整度、历史文档的沉淀质量、系统之间能否打通,往往先被逐项盘查。有服务商反映,前期评估时间明显拉长,交付节奏从过去的数周延伸到数月量级,而这一变化恰恰说明企业开始为长期运行做准备。
三、成本与组织是绕不开的两道坎
落地阶段的阻力,多半不在技术侧。推理与运维的持续开销、标注与校验的隐性人力、跨部门责任的划分,都会影响一个项目能否长期维持。AI输出出了问题由谁负责、审计留痕如何满足内控要求,这些问题的答案往往比模型选型更耗时间。大企业偏向私有化与定制,中小企业更愿意接受开箱即用的订阅服务,两条路径的分化已经比较清晰。
展望接下来一段时间,行业大概率沿着三条线索演进:场景继续收敛,从“什么都能做”转向少数高频刚需;底座先行,数据与接口的整理先于模型上线;评估量化,投入产出需要能被清楚地讲出来。对企业来说,与其追赶模型版本号,不如先把自身的流程与数据账算明白——能否在不增加额外负担的前提下嵌入既有工作流,将决定这批项目的留存率。